
Wie viel testen ist genug? Spoiler: Es ist nicht die Prozentzahl!
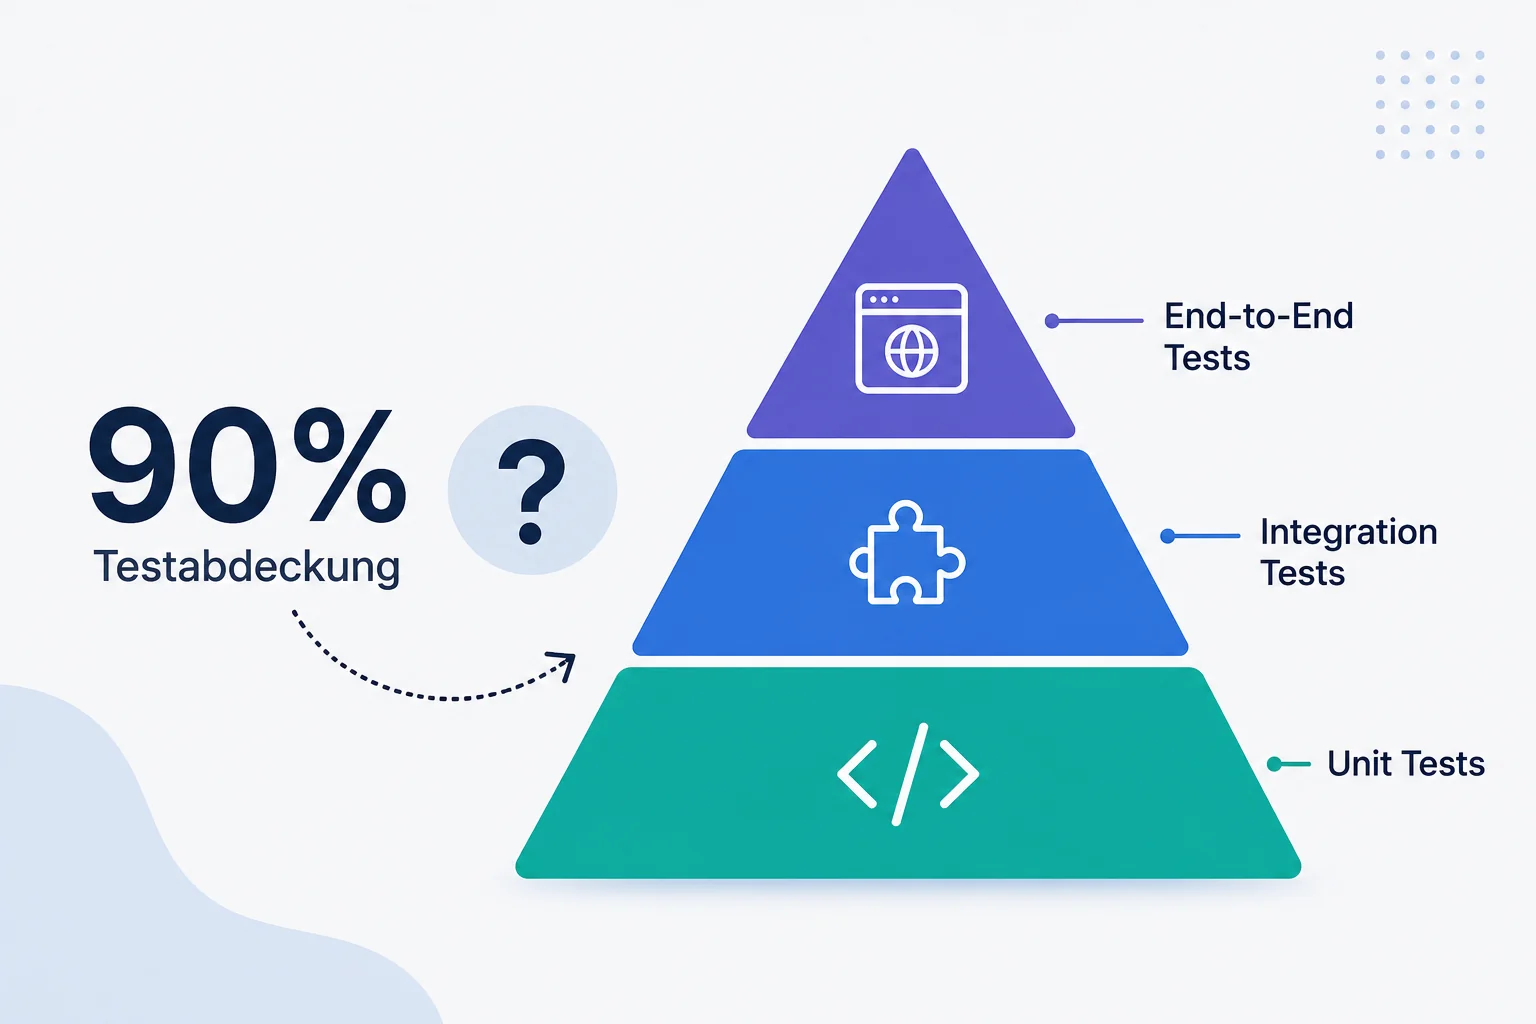
„Wir haben 90 % Testabdeckung." Das klingt zunächst einmal ziemlich gut. Eine hohe Zahl vermittelt Sicherheit und lässt sich hervorragend in Reports, Dashboards und Management-Präsentationen darstellen.
Gleichzeitig bleibt oft offen, was diese Zahl eigentlich aussagt. Ist eine Anwendung mit 90 % Testabdeckung automatisch gut getestet? Sind 70 % zu wenig? Und wie viele automatisierte Tests braucht ein Projekt überhaupt?
Eine einzelne Prozentzahl kann diese Fragen nicht beantworten. Testabdeckung ist ein wertvolles Werkzeug, aber kein Qualitätsziel. Entscheidend ist nicht, möglichst viel Code zu testen, sondern die relevanten Risiken eines Produkts angemessen abzusichern.
Dabei spielen für mich vier Bereiche eine zentrale Rolle.
1. Die Testpyramide: Der richtige Mix an Tests
Die Testpyramide ist für mich nach wie vor eine gute Orientierung, wenn es darum geht, eine sinnvolle Teststrategie aufzubauen. Die Grundidee ist einfach: Je höher ein Test in der Pyramide angesiedelt ist, desto größer ist typischerweise sein Scope und desto aufwendiger und langsamer ist seine Ausführung.
Am unteren Ende stehen viele schnelle Tests, beispielsweise Unit Tests. Darüber folgen Integrationstests und weitere Tests mit größerem Scope. An der Spitze befinden sich wenige, gezielte End-to-End-Tests. Der entscheidende Punkt ist dabei nicht, eine bestimmte Anzahl oder ein bestimmtes Verhältnis exakt einzuhalten.
Die Pyramide soll vor allem helfen, Testaufwand und Risiko sinnvoll auszubalancieren. Eine Anwendung mit komplexen Preisberechnungen lässt sich zum Beispiel sehr gut mit vielen schnellen Tests auf niedriger Ebene absichern.
Dafür jedes mögliche Szenario ausschließlich über die Benutzeroberfläche und einen End-to-End-Test abzudecken, wäre unnötig langsam und würde Fehler zudem schwerer lokalisierbar machen.
Auf der anderen Seite kann ein End-to-End-Test für einen geschäftskritischen Kaufprozess sehr wertvoll sein. Er überprüft, ob mehrere Komponenten gemeinsam tatsächlich funktionieren. Wichtiger als die reine Anzahl ist deshalb die Frage, auf welcher Testebene sich ein Risiko am effektivsten und zuverlässigsten absichern lässt.
Die Testpyramide ist damit weniger eine mathematische Formel als eine Orientierung für die Teststrategie.
2. Testabdeckung: 90 % sind nicht automatisch besser
Code Coverage ist eine nützliche Metrik. Sie kann beispielsweise zeigen, welcher Anteil des Codes während der Ausführung automatisierter Tests tatsächlich durchlaufen wurde. Damit lässt sich erkennen, welche Bereiche möglicherweise überhaupt nicht von Tests erreicht werden.
Das macht Coverage wertvoll. Problematisch wird es allerdings, wenn aus der Metrik ein starres Ziel wird, etwa nach dem Muster „Wir müssen mindestens 90 % erreichen." Denn Code Coverage beantwortet zunächst nur eine Frage: Welcher Code wurde durch unsere Tests ausgeführt?
Sie beantwortet nicht automatisch, ob dieser Code auch sinnvoll getestet wurde. Stell dir beispielsweise eine Funktion vor, die entscheidet, ob ein Benutzer eine bestimmte Aktion ausführen darf. Ein Test könnte die Funktion ausführen und damit die entsprechende Codezeile abdecken. Trotzdem könnte der Test möglicherweise nur den Happy Path überprüfen.
Nicht getestet wurden dann vielleicht:
- ungültige Eingaben
- Grenzwerte
- fehlende Berechtigungen
- Fehlerfälle
- unterschiedliche Benutzerrollen
- unerwartete Systemzustände
Die Code Coverage kann trotzdem sehr hoch sein. Deshalb ist es wichtiger, was getestet wird, als ausschließlich darauf zu schauen, wie viel Code durch Tests ausgeführt wird.
Besonders relevant sind beispielsweise:
- kritische Geschäftsprozesse
- Business-Logik
- sicherheitsrelevante Funktionen
- häufig geänderte Komponenten
- fehleranfällige Bereiche
- komplexe Berechnungen
- Schnittstellen zu anderen Systemen
Eine Anwendung mit 70 % Coverage kann deshalb unter Umständen besser abgesichert sein als eine Anwendung mit 95 % Coverage. Die Prozentzahl ist nicht nutzlos. Sie ist nur nicht die Antwort auf die Frage, ob ausreichend getestet wurde.
3. Schnelles Feedback: Tests müssen rechtzeitig reagieren
Ein guter automatisierter Test sollte nicht nur korrekt sein. Er sollte auch rechtzeitig Feedback liefern. Denn der Wert eines Tests hängt stark davon ab, wann ein Problem entdeckt wird.
Wenn ein Entwickler eine Änderung macht und wenige Minuten später erfährt, dass dadurch ein wichtiger bestehender Prozess kaputtgegangen ist, kann das Problem direkt behoben werden. Wenn dasselbe Feedback erst mehrere Stunden später oder sogar kurz vor dem Release kommt, sieht die Situation ganz anders aus.
Der Fehler muss möglicherweise erst analysiert werden. Andere Änderungen sind inzwischen hinzugekommen. Der Kontext ist nicht mehr präsent. Vielleicht muss sogar ein kompletter Releaseprozess unterbrochen werden. Je später Fehler erkannt werden, desto höher sind meist Aufwand und Kosten für ihre Behebung.
Das bedeutet nicht, dass langsame Tests grundsätzlich schlecht sind. Ein langsamer End-to-End-Test kann einen enormen Wert haben, wenn er ein relevantes Risiko absichert. Problematisch wird es, wenn ein großer Teil der Teststrategie aus langsamen oder instabilen Tests besteht.
Besonders kritisch sind dabei sogenannte flaky Tests. Tests, die manchmal erfolgreich und manchmal fehlschlagen, obwohl sich am Produkt nichts geändert hat.
Auf Dauer führt das oft dazu, dass das Team das Vertrauen in die Tests verliert.
Fehlschläge werden ignoriert. Testreports werden weggeklickt. Rote Builds werden zur Normalität. Damit verliert die Automatisierung einen ihrer wichtigsten Vorteile: vertrauenswürdiges Feedback.
Eine kleinere Anzahl schneller und stabiler Tests kann deshalb wesentlich wertvoller sein als eine riesige Testsuite, deren Ergebnisse erst spät vorliegen und ständig manuell überprüft werden müssen.
4. Production Feedback: Tests enden nicht beim Release
Auch die besten automatisierten Tests können nicht jede Situation abdecken. Eine Testumgebung bildet die Realität nur begrenzt ab. In der Produktivumgebung gibt es reale Benutzer, reale Daten, reale Last und Kombinationen von Bedingungen, die in einer Testumgebung möglicherweise nie auftreten.
Deshalb endet eine gute Teststrategie nicht mit dem erfolgreichen Deployment. Monitoring, Observability, Canary Releases und Feature Flags können automatisierte Tests sinnvoll ergänzen.
Ein Canary Release ermöglicht beispielsweise, eine neue Version zunächst nur für einen kleinen Teil der Benutzer bereitzustellen. Über Monitoring und relevante Metriken lässt sich beobachten, ob sich das Verhalten gegenüber der bisherigen Version verändert. Feature Flags können zusätzlich ermöglichen, eine Funktion kontrolliert zu aktivieren oder bei Problemen wieder zu deaktivieren.
Damit entsteht eine weitere Ebene der Qualitätssicherung. Es geht also nicht nur darum, vor dem Release zu testen, sondern das Verhalten einer Anwendung auch danach aufmerksam zu beobachten.
Das bedeutet nicht, dass Fehler einfach in der Produktivumgebung gefunden werden sollen.
Im Gegenteil: Je besser die automatisierten Tests sind, desto weniger Risiken sollten überhaupt bis zur Produktion gelangen. Production Feedback ist vielmehr eine zusätzliche Sicherheitslinie für die Risiken, die sich vorher nicht vollständig erkennen lassen.
Also: Wie viel testen ist genug?
Die vielleicht wichtigste Erkenntnis ist, dass es darauf keine universelle Prozentzahl gibt. 90 % Coverage sind nicht automatisch gut. 50 % Coverage sind nicht automatisch schlecht.
Und auch die Anzahl der automatisierten Tests sagt allein wenig über die Qualität einer Teststrategie aus.
Die entscheidende Frage lautet vielmehr: Welche Risiken sind für unser Produkt relevant und wie gut können wir sie erkennen, bevor sie Auswirkungen auf unsere Kunden haben?
Daraus lassen sich konkrete Entscheidungen ableiten:
- Welche Funktionen sind geschäftskritisch?
- Welche Komponenten ändern sich besonders häufig?
- Wo entstehen die meisten Fehler?
- Welche Fehler hätten die größten Auswirkungen auf Kunden oder Unternehmen?
- Welche Tests liefern schnelles und vertrauenswürdiges Feedback?
- Welche Risiken können wir durch Monitoring, kontrollierte Releases oder Feature Flags zusätzlich absichern?
Genau daraus entsteht eine sinnvolle Teststrategie. Nicht aus einer möglichst hohen Prozentzahl.
Fazit
Testautomatisierung bedeutet nicht, möglichst viele Tests zu schreiben. Und eine gute Teststrategie bedeutet auch nicht, eine möglichst hohe Code Coverage zu erreichen.
Das Ziel sollte vielmehr sein, mit dem vorhandenen Testaufwand möglichst relevante Risiken abzudecken und möglichst schnell zuverlässiges Feedback zu erhalten.
Die Testpyramide hilft beim richtigen Mix der Testarten. Code Coverage hilft dabei, blinde Flecken zu erkennen. Schnelle und stabile Tests sorgen für schnelles Feedback.
Monitoring, Canary Releases und Feature Flags helfen dabei, Risiken auch nach dem Deployment zu erkennen und zu begrenzen.
Am Ende entscheidet nicht die Anzahl der Tests über Qualität und auch nicht eine einzelne Prozentzahl. Entscheidend ist, ob wir die richtigen Risiken zur richtigen Zeit mit den passenden Tests absichern.