Wie viel Testen ist genug? Warum Code Coverage nicht die Antwort ist
„Wir haben 90% Code Coverage.“ Das klingt zunächst einmal ziemlich gut. Eine hohe Zahl vermittelt Sicherheit und macht in Reports und Management-Präsentationen einiges her.
Offen bleibt dabei oft, was diese Zahl eigentlich aussagt. Ist eine Anwendung mit 90% Code Coverage automatisch gut getestet? Sind 70% zu wenig? Und wie viele automatisierte Tests braucht ein Projekt überhaupt?
Eine einzelne Prozentzahl kann diese Fragen nicht beantworten. Code Coverage ist ein wertvolles Werkzeug, aber kein Qualitätsziel. Mir geht es darum, die relevanten Risiken eines Produkts abzusichern. Wie viel Code die Tests dabei durchlaufen, ist zweitrangig. Dafür sind für mich vier Bereiche besonders wichtig.
1. Die Testpyramide: Der richtige Mix an Tests
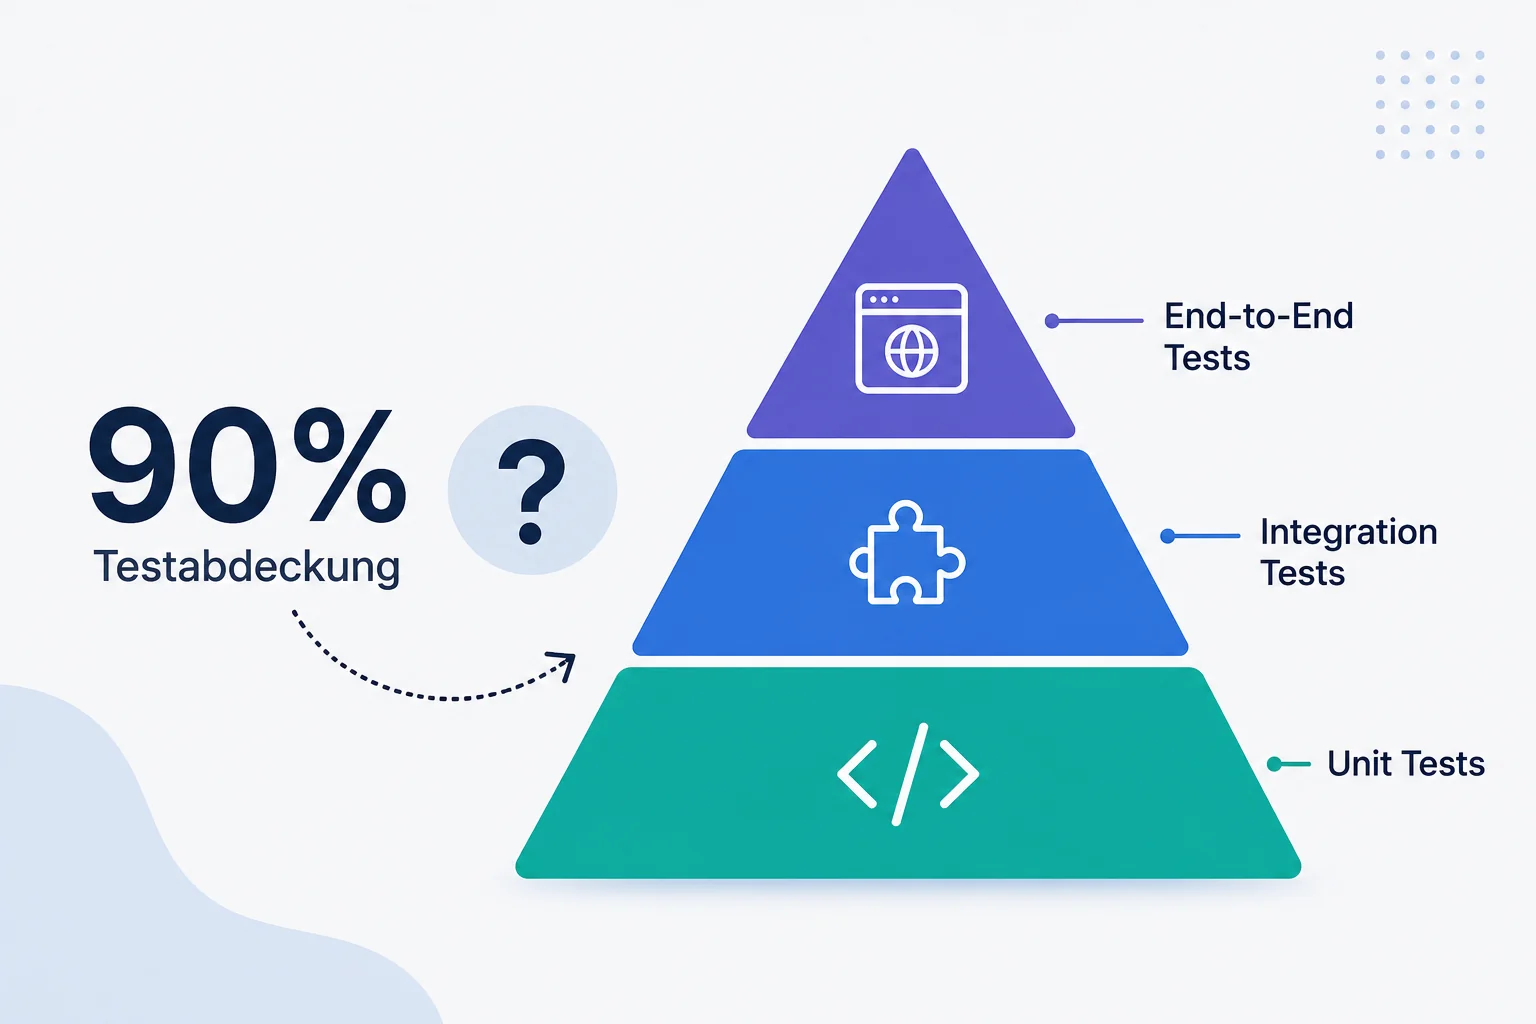
Die Testpyramide ist für mich nach wie vor eine gute Orientierung für eine sinnvolle Teststrategie. Die Grundidee ist einfach: Je höher ein Test in der Pyramide steht, desto mehr vom System prüft er in der Regel und desto aufwendiger und langsamer läuft er.
Am unteren Ende stehen viele schnelle Tests, beispielsweise Unit-Tests. Darüber folgen Integrationstests und weitere Tests, die größere Teile des Systems prüfen. An der Spitze befinden sich wenige, gezielte E2E-Tests. Dabei geht es nicht darum, eine bestimmte Anzahl oder ein festes Verhältnis einzuhalten.
Die Pyramide soll vor allem helfen, Testaufwand und Risiko sinnvoll auszubalancieren. Eine Anwendung mit komplexen Preisberechnungen lässt sich zum Beispiel sehr gut mit vielen schnellen Tests auf niedriger Ebene absichern. Jedes Szenario über die Benutzeroberfläche zu testen, wäre dagegen unnötig langsam. Außerdem ließen sich Fehler schwerer lokalisieren.
Auf der anderen Seite kann ein E2E-Test für einen geschäftskritischen Kaufprozess sehr wertvoll sein. Er prüft, ob mehrere Komponenten im Zusammenspiel wirklich funktionieren. Wichtiger als die reine Anzahl ist deshalb die Frage: Auf welcher Testebene lässt sich ein Risiko am effektivsten absichern?
2. Code Coverage: 90% sind nicht automatisch besser
Code Coverage ist eine nützliche Metrik. Sie zeigt, welchen Anteil des Codes die automatisierten Tests tatsächlich durchlaufen. So erkennst du Bereiche, die möglicherweise gar kein Test erreicht.
Das macht Coverage wertvoll. Problematisch wird es allerdings, wenn aus der Metrik ein starres Ziel wird, etwa nach dem Muster: „Wir müssen mindestens 90% erreichen.“ Denn Code Coverage beantwortet zunächst nur eine Frage: Welchen Code haben unsere Tests ausgeführt?
Sie beantwortet nicht automatisch, ob dieser Code auch sinnvoll getestet wurde. Stell dir beispielsweise eine Funktion vor, die entscheidet, ob ein Benutzer eine bestimmte Aktion ausführen darf. Ein Test könnte die Funktion ausführen und damit die entsprechende Codezeile abdecken. Vielleicht prüft er dabei aber nur den Happy Path. Ungültige Eingaben, Grenzwerte, fehlende Berechtigungen oder andere Benutzerrollen bleiben dann ungetestet.
Die Code Coverage kann trotzdem sehr hoch sein. Deshalb ist wichtiger, was getestet wird, als wie viel Code die Tests ausführen. Besonders relevant sind zum Beispiel kritische Geschäftsprozesse, sicherheitsrelevante Funktionen und komplexe Berechnungen. Dazu kommen Bereiche, die sich häufig ändern oder in denen oft Fehler auftreten, und Schnittstellen zu anderen Systemen.
Eine Anwendung mit 70% Coverage kann deshalb unter Umständen besser abgesichert sein als eine Anwendung mit 95 % Coverage. Nutzlos ist die Prozentzahl damit nicht. Sie zeigt nur nicht, ob ausreichend getestet wurde.
3. Schnelles Feedback: Fehler früh erkennen
Ein guter automatisierter Test muss korrekt prüfen und rechtzeitig Feedback liefern. Sein Wert hängt stark davon ab, wann er ein Problem entdeckt.
Stell dir vor, ein Entwickler ändert etwas am Code und erfährt wenige Minuten später, dass ein wichtiger Prozess kaputt ist. Dann kann er das Problem direkt beheben. Kommt dasselbe Feedback erst Stunden später oder kurz vor dem Release, sieht die Situation ganz anders aus.
Dann muss das Team den Fehler oft erst analysieren. Andere Änderungen sind inzwischen hinzugekommen, und der Entwickler ist gedanklich schon bei etwas anderem. Vielleicht muss sogar ein kompletter Release-Prozess unterbrochen werden. Je später ein Fehler auffällt, desto aufwendiger und teurer ist es meist, ihn zu beheben.
Das bedeutet nicht, dass langsame Tests grundsätzlich schlecht sind. Ein langsamer E2E-Test kann sehr wertvoll sein, wenn er ein relevantes Risiko absichert. Problematisch wird es, wenn ein großer Teil der Tests langsam oder instabil ist.
Besonders kritisch sind dabei sogenannte Flaky Tests. Das sind Tests, die manchmal erfolgreich sind und manchmal fehlschlagen, obwohl sich am Produkt nichts geändert hat. Auf Dauer verliert das Team dadurch oft das Vertrauen in die Tests. Fehlschläge werden dann ignoriert und Testreports weggeklickt, rote Builds sind irgendwann normal. Damit fehlt der Automatisierung einer ihrer wichtigsten Vorteile: verlässliches Feedback.
Wenige schnelle und stabile Tests können deshalb wertvoller sein als eine riesige Testsuite. Das gilt vor allem, wenn deren Ergebnisse erst spät vorliegen und ständig manuell geprüft werden müssen. Wie Continuous Integration und klare Testregeln dabei helfen, beschreibe ich im Artikel Welche Entwicklungspraktiken sich bewährt haben.
4. Feedback aus der Produktion: Tests enden nicht beim Release
Auch die besten automatisierten Tests können nicht jede Situation abdecken. Eine Testumgebung bildet die Realität nur begrenzt ab. In der Produktivumgebung arbeiten echte Benutzer mit echten Daten. Dazu kommen Lastspitzen und Kombinationen von Bedingungen, die in einer Testumgebung vielleicht nie auftreten.
Deshalb endet eine gute Teststrategie nicht mit dem erfolgreichen Deployment. Monitoring, Observability, Canary Releases und Feature Flags können automatisierte Tests sinnvoll ergänzen.
Bei einem Canary Release bekommt zum Beispiel zunächst nur ein kleiner Teil der Benutzer die neue Version. Über Monitoring und relevante Metriken siehst du, ob sich das Verhalten gegenüber der bisherigen Version verändert. Mit Feature Flags aktivierst du eine Funktion kontrolliert und schaltest sie bei Problemen wieder ab. So kommt nach dem Release eine weitere Ebene der Qualitätssicherung dazu: Du beobachtest, wie sich die Anwendung im Betrieb verhält.
Das heißt nicht, dass du Fehler einfach erst in der Produktivumgebung finden sollst. Im Gegenteil: Je besser die automatisierten Tests sind, desto weniger Fehler kommen überhaupt bis in die Produktion. Feedback aus der Produktion ist ein zusätzliches Sicherheitsnetz für die Risiken, die sich vorher nicht vollständig erkennen lassen.
Also: Wie viel Testen ist genug?
Aus meiner Sicht gibt es keine Prozentzahl, die für jedes Projekt passt. 90% Coverage sind nicht automatisch gut und 50 % nicht automatisch schlecht. Und auch die Anzahl der automatisierten Tests sagt allein wenig über die Qualität einer Teststrategie aus.
Wichtiger ist für mich, welche Risiken für unser Produkt relevant sind und wie gut wir sie erkennen, bevor sie unsere Kunden treffen. Daraus ergeben sich konkretere Fragen:
- Welche Funktionen sind geschäftskritisch?
- Welche Komponenten ändern sich besonders häufig?
- Wo entstehen die meisten Fehler?
- Welche Fehler hätten die größten Auswirkungen auf Kunden oder Unternehmen?
- Welche Tests liefern schnelles und vertrauenswürdiges Feedback?
- Welche Risiken können wir durch Monitoring, kontrollierte Releases oder Feature Flags zusätzlich absichern?
Fazit
Bei Testautomatisierung geht es mir nicht um möglichst viele Tests oder eine möglichst hohe Code Coverage. Das Ziel ist, mit dem vorhandenen Testaufwand die relevanten Risiken abzudecken und schnell zuverlässiges Feedback zu bekommen.
Die Testpyramide hilft beim richtigen Mix der Testarten. Code Coverage zeigt blinde Flecken. Schnelle und stabile Tests melden Fehler früh. Monitoring, Canary Releases und Feature Flags begrenzen Risiken auch nach dem Deployment. Am Ende zählt für mich, ob wir die wichtigen Risiken rechtzeitig absichern.
Mein Vorschlag für den Anfang: Nimm dir die Fragen aus der Liste oben vor. Beantworte sie gemeinsam mit deinem Team für eure drei wichtigsten Abläufe. Das ist eine bessere Grundlage für eure Teststrategie als jede Zielquote. Wie du eine Teststrategie Schritt für Schritt aufbaust, ist auch Teil der Schulung Testautomatisierung für Einsteiger mit Playwright.