5 Grundlagen der Testautomatisierung, die KI nicht ersetzt
GitHub Copilot hat mir vor Kurzem in zwei Minuten E2E-Tests für ein Kundenprojekt geschrieben. Die Playwright-Tests liefen direkt grün durch. Erst im Code-Review habe ich gemerkt, wie wenig sie eigentlich geprüft haben.
Zwei Dinge sind mir aufgefallen. Die Selektoren hingen an drei verschachtelten CSS-Klassen. Und der Test hat nicht seine eigene Bestellung geprüft, sondern einfach die letzte im System. Wäre die neue Bestellung fehlgeschlagen, hätte der Test trotzdem eine bestätigte Bestellung gefunden und wäre grün geblieben.
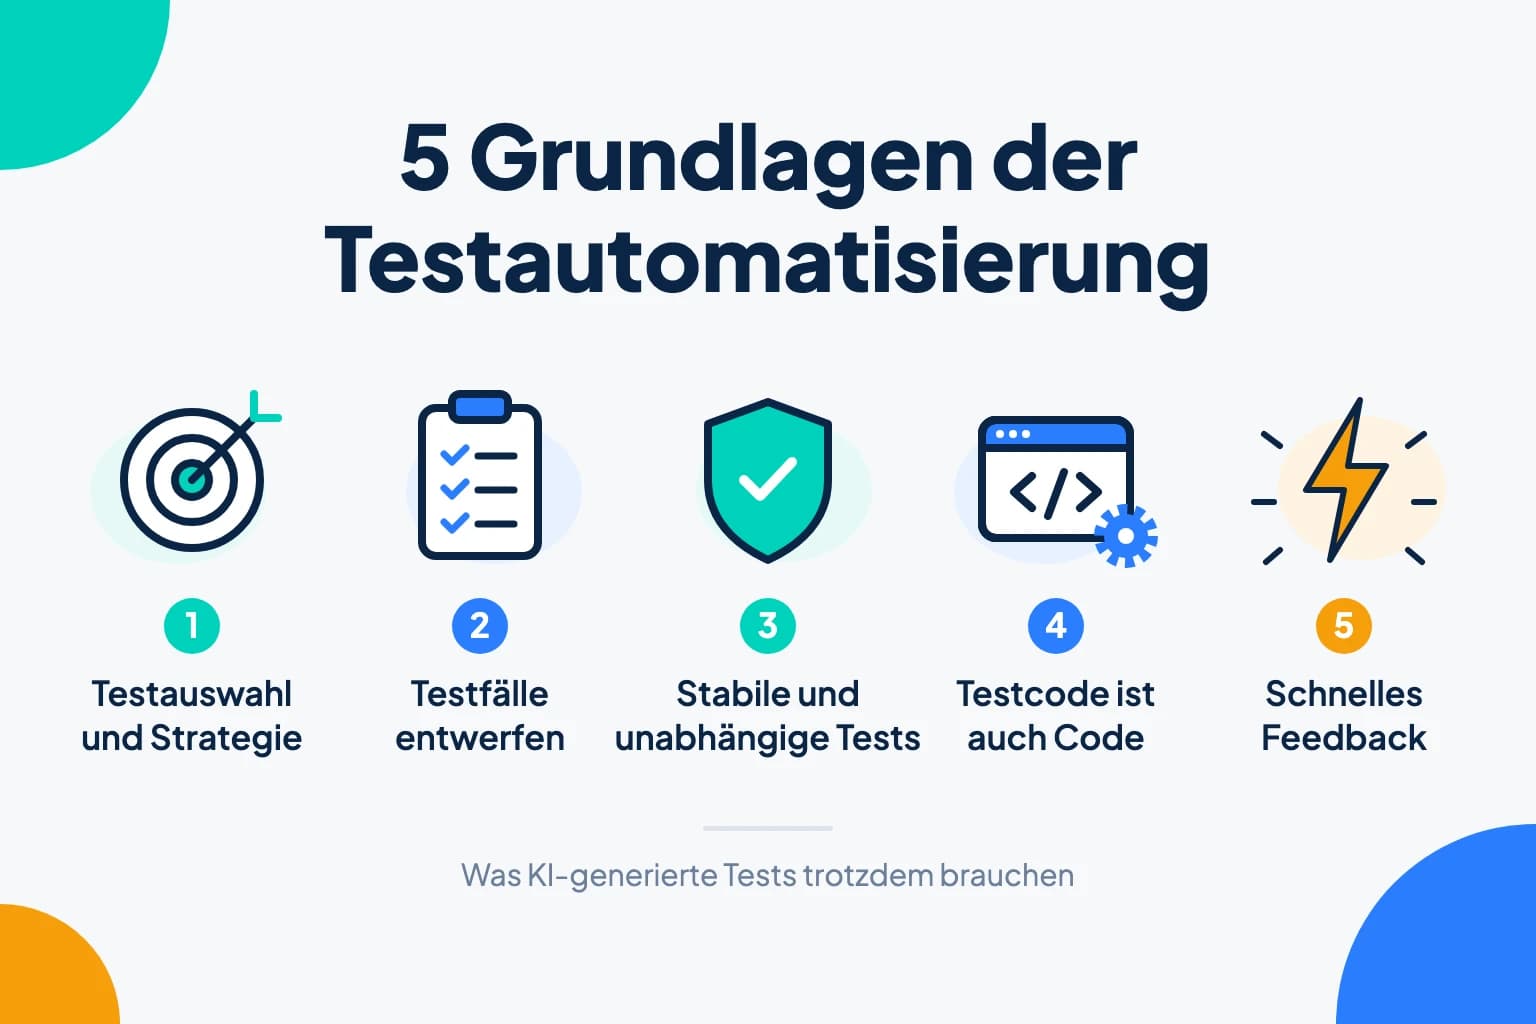
Ich nutze KI-Tools beim Testen jeden Tag, weil sie mir viel Routinearbeit abnehmen. Den erzeugten Code muss ich aber bewerten können. Dafür brauche ich die Grundlagen der Testautomatisierung. Fünf davon sind mir besonders wichtig. Zu jeder zeige ich, wie sie sich in Projekten konkret umsetzen lässt.
1. Testauswahl und Strategie
Nur weil sich etwas automatisieren lässt, automatisiere ich es noch lange nicht. Die Frage „Was sollten wir eigentlich automatisieren?“ kommt in Projekten oft zu kurz. Mit KI wird sie noch wichtiger, denn neue Tests kosten plötzlich kaum noch Zeit. Die Wartung kostet aber weiterhin Zeit, und jeder zusätzliche E2E-Test macht die Pipeline langsamer.
Am Anfang hilft eine einfache Risikobetrachtung. Für jeden Bereich der Anwendung fragst du dich: Wie wahrscheinlich ist hier ein Fehler, und wie teuer wäre er? Ein Bestellprozess in einem Shop ist geschäftskritisch und bekommt einen E2E-Test. Ein Impressum, das sich zweimal im Jahr ändert, eher nicht.
Genauso wichtig ist die Frage nach der richtigen Testebene. Rabattregeln mit vielen Kombinationen teste ich nicht über die Oberfläche. Dafür nehme ich Unit- oder API-Tests, die in Millisekunden laufen. Der E2E-Test prüft dann nur noch, ob der Rabatt im Checkout ankommt. Warum eine hohe Testabdeckung dabei kein gutes Ziel ist, beschreibe ich im Artikel Wie viel Testen ist genug?.
2. Testfälle entwerfen
Bevor ich eine Zeile Testcode schreibe, lege ich für jeden Testfall drei Dinge fest: die Vorbedingungen, die Testdaten und das erwartete Ergebnis. Erst dann kann ich beurteilen, ob ein Test das Richtige prüft. Genau das fehlte beim Copilot-Test. Ein eigenes erwartetes Ergebnis hatte er nicht. Ihm reichte irgendeine Bestellung mit dem Status „Bestätigt“. So ähnlich sah die Prüfung aus:
await page.goto('/bestellungen');
// die neueste Bestellung steht oben in der Liste
await expect(
  page.locator('.order-list .order-item:first-child .status')
).toHaveText('Bestätigt');
Der Test findet immer eine passende Bestellung, solange irgendwann irgendwer erfolgreich bestellt hat. Ob die eigene Bestellung funktioniert hat, prüft er nicht. Besser ist es, sich die Bestellnummer aus der Bestätigung zu merken und danach genau diese Bestellung zu suchen:
const orderNumber = await page.getByTestId('order-number').innerText();

await page.goto('/bestellungen');
const order = page.getByRole('row', { name: orderNumber });
await expect(order).toContainText('Bestätigt');
Jetzt schlägt der Test fehl, sobald die eigene Bestellung nicht ankommt. Beim Entwurf hilft mir eine Frage: Was müsste kaputtgehen, damit dieser Test rot wird? Wenn dir darauf keine überzeugende Antwort einfällt, prüft der Test vermutlich zu wenig. Wer Testfälle vorher strukturiert beschreiben möchte, findet mit Given, When und Then ein gutes Format im Artikel Gherkin einfach erklärt.
3. Stabile und unabhängige Tests
Jeder Test muss für sich allein und in beliebiger Reihenfolge laufen können. Flaky Tests und verkettete Abhängigkeiten sind die Anti Patterns, die ich in Projekten am häufigsten sehe. Ein typisches Beispiel: Test A legt einen Kunden an, Test B bestellt mit diesem Kunden, Test C storniert die Bestellung. Fällt A aus, werden auch B und C rot. Und sobald die Tests parallel laufen, kommen sie sich gegenseitig in die Quere.
Testdaten über die API anlegen
Die wichtigste Regel für unabhängige Tests lautet für mich: Jeder Test legt seine Daten selbst an. Dafür nutze ich die API der Anwendung statt der Oberfläche. Legt der Test den Kunden über die Registrierungsseite an, kostet das mehrere Sekunden. Außerdem hängt er dann an einer Seite, die er gar nicht prüfen soll. Über die API dauert das ein paar Millisekunden.
In Playwright eignet sich dafür eine Fixture. Sie legt die Daten vor dem Test an, gibt sie an den Test weiter und räumt danach wieder auf:
import { test as base, expect } from '@playwright/test';

const test = base.extend({
  customer: async ({ request }, use) => {
    const email = `kunde-${crypto.randomUUID()}@example.com`;
    const response = await request.post('/api/customers', { data: { email } });
    const customer = await response.json();

    await use(customer);

    await request.delete(`/api/customers/${customer.id}`);
  },
});

test('Kunde kann ein Produkt bestellen', async ({ page, customer }) => {
  // Der Test arbeitet nur mit seinem eigenen Kunden
});
Die zufällige Kennung in der E-Mail-Adresse ist dabei wichtig. Laufen vier Tests parallel, hat jeder seinen eigenen Kunden, und keiner überschreibt die Daten eines anderen. Selbst wenn das Aufräumen einmal fehlschlägt, stört der übrig gebliebene Datensatz keinen späteren Testlauf.
Ähnlich geht es beim Login. Ein Setup-Projekt meldet sich einmal an und speichert den
Zustand mit storageState. Die eigentlichen Tests starten dann
bereits angemeldet.
Nicht jede Anwendung hat eine passende API. Dann hilft ein Endpunkt nur für die Testumgebung, der Testdaten anlegt und wieder löscht. So ein Endpunkt ist meist schnell gebaut und spart danach in jedem Testlauf Zeit.
Warten ohne feste Pausen
Die zweite häufige Ursache für Flaky Tests sind feste Wartezeiten. Ein
waitForTimeout(3000) reicht auf dem eigenen Rechner und ist in der Pipeline manchmal zu kurz. Playwright wartet bei Aktionen und bei
Assertions wie toBeVisible() oder toHaveText()
automatisch, bis das Element bereit ist. Feste Pausen haben deshalb im
Testcode nichts verloren, auch wenn sie von einer KI kommen.
4. Testcode ist auch Code
Testautomatisierung ist Softwareentwicklung. Tests müssen genauso lesbar und wartbar sein wie jeder andere Code. Am deutlichsten sieht man das an den Selektoren. Mit einer Kette aus CSS-Klassen wie im Copilot-Test wird der Test beim nächsten Redesign rot, obwohl sich an der Funktion nichts geändert hat:
// bricht, sobald sich das Layout ändert
page.locator('div.checkout > div.summary > span.total');

// beschreibt, was der Benutzer sieht
page.getByRole('button', { name: 'Jetzt kaufen' });

// fester Vertrag zwischen Entwicklung und Test
page.getByTestId('order-total');
Meine Reihenfolge ist dabei immer gleich. Zuerst versuche ich Selektoren über
Rolle und sichtbaren Text, also getByRole oder
getByLabel. Die prüfen nebenbei auch, ob die Seite für
Screenreader sinnvoll aufgebaut ist. Wo das nicht reicht, zum Beispiel bei
einem Gesamtbetrag ohne eindeutige Beschriftung, nutze ich eine Test-ID.
Test-IDs sollten fest mit den Entwicklern abgesprochen sein. Ein
Attribut
wie data-testid="order-total" hat keine Bedeutung für das Layout
und wird bei einem Redesign nicht versehentlich umbenannt. Wenn das Projekt
bereits einen anderen Namen verwendet, zum Beispiel data-test,
stellst du ihn in der Playwright-Konfiguration über
testIdAttribute ein.
Wiederholte Abläufe wie der Checkout gehören außerdem in eine eigene Funktion oder ein Page Object, statt in zwanzig Tests kopiert zu werden. Und Testcode läuft durch dasselbe Code-Review wie der Produktivcode. Genau dort sind mir die Schwächen im Copilot-Test aufgefallen. Wie Playwright Selektoren und automatisches Warten umsetzt, erkläre ich ausführlicher im Überblicksartikel.
5. Schnelles Feedback
Tests, die erst kurz vor dem Release laufen, kommen zu spät. Bis dahin sind viele Änderungen zusammengekommen, und keiner weiß mehr genau, welche davon den Fehler verursacht hat. Für mich gehören Tests deshalb in die Pipeline und laufen bei jeder Änderung, spätestens bei jedem Pull Request.
Damit das praktikabel bleibt, müssen die Tests schnell sein. Unabhängige Tests
aus Abschnitt 3 sind dafür die Voraussetzung, denn nur sie lassen sich
parallel ausführen. Playwright verteilt sie auf mehrere Worker und bei großen
Suites mit --shard auf mehrere Maschinen. Zusätzlich lassen
sich die wichtigsten Abläufe mit einem Tag wie @smoke markieren.
Diese Auswahl läuft bei jedem Commit in wenigen Minuten, die komplette Suite vor dem Merge oder nachts.
Wenn ein Test in der Pipeline fehlschlägt, brauche ich schnell den Grund.
Dafür gibt es in der Konfiguration die Einstellung
trace: 'on-first-retry'. Schlägt ein Test fehl, zeichnet Playwright beim ersten Wiederholungsversuch einen Trace auf. Darin siehst du jeden Schritt mit Screenshot und Netzwerkanfragen.
Retries setze ich bewusst sparsam ein. Ein Test, der erst im zweiten Versuch grün wird, taucht im Report als „flaky“ auf. Für mich ist das ein Arbeitsauftrag. Mehr zu Continuous Integration und klaren Testregeln im Team findest du im Artikel Welche Entwicklungspraktiken sich bewährt haben.
Fazit
Diese Grundlagen sind aus meiner Sicht wichtiger als die Frage, welches Tool oder Framework du verwendest. Sie entscheiden auch darüber, ob KI beim Testen
hilft oder nur viele grüne Tests produziert. Es lohnt sich, Copilot die
eigenen Regeln direkt mitzugeben. In der Datei
.github/copilot-instructions.md kann zum Beispiel stehen, dass Tests ihre Daten über die API anlegen und Selektoren Rollen oder Test-IDs verwenden. Die Vorschläge passen dann besser zu den Konventionen im
Projekt. Ein Code-Review ersetzt die Datei aber nicht.
Ein einfacher erster Schritt: Nimm einen bestehenden E2E-Test und lass ihn
mit npx playwright test --repeat-each=10 --workers=4 laufen. Wird
er dabei auch nur einmal rot, hängt er vermutlich an fremden Testdaten oder an
festen Wartezeiten. Wie du KI-Tools beim Testen gezielt einsetzt und ihre
Ergebnisse bewertest, lernst du in der Schulung
Testautomatisierung mit KI und Playwright.